Transformer Architecture: Fast Attention, Rotary Positional Embeddings, and Multi-Query Attention
Автор: Rajistics - data science, AI, and machine learning
Загружено: 2023-07-28
Просмотров: 897
Описание:
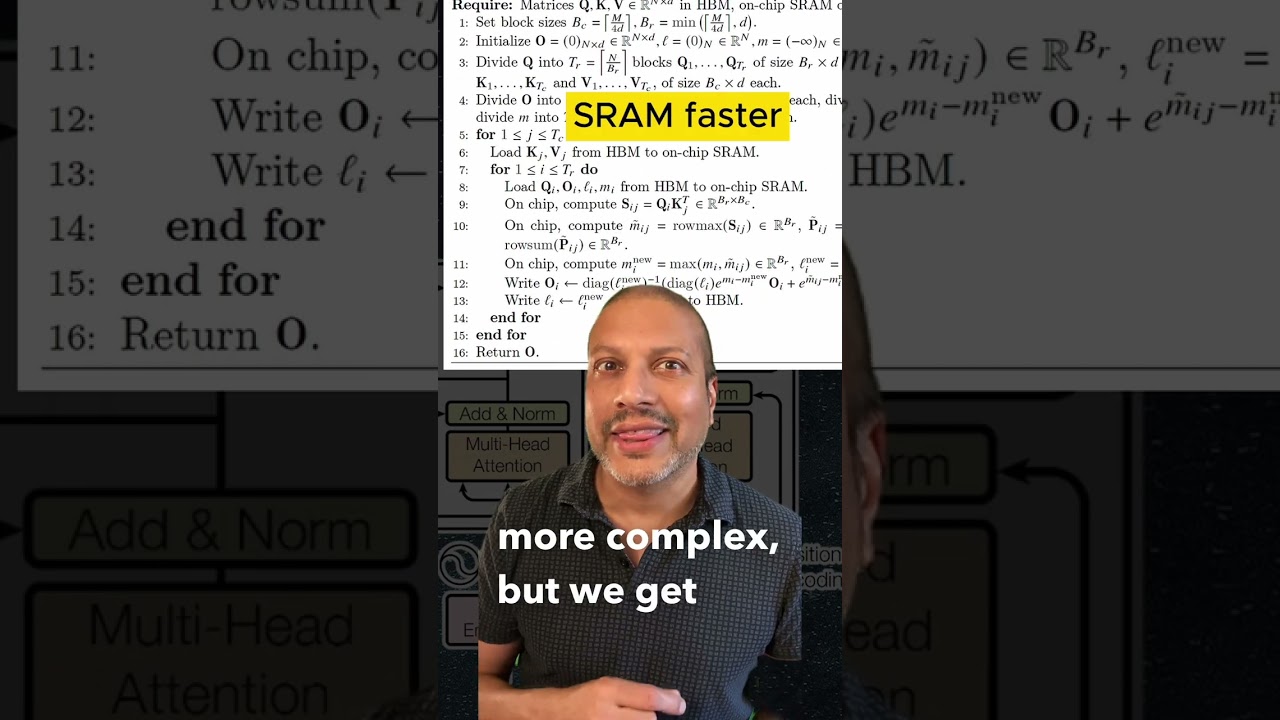
Three major improvements to the transformer architecture that everyone should know. They include Fast Attention, Rotary Positional Embeddings, and Multi-Query Attention.
#machinelearning #largelanguagemodels #positionalencodings #flashattention #mulitqueryattention
Useful Links:
Learning position with Positional Encoding: https://www.scaler.com/topics/nlp/pos...
ROFORMER: ENHANCED TRANSFORMER WITH ROTARY
POSITION EMBEDDING: https://arxiv.org/pdf/2104.09864.pdf
Rotary Embeddings: A Relative Revolution - https://blog.eleuther.ai/rotary-embed...
Flash Attention: https://github.com/Dao-AILab/flash-at...
GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints: https://arxiv.org/abs/2305.13245
━━━━━━━━━━━━━━━━━━━━━━━━━
★ Rajistics Social Media »
● Link Tree: https://linktr.ee/rajistics
● LinkedIn: / rajistics
━━━━━━━━━━━━━━━━━━━━━━━━━
Повторяем попытку...
Доступные форматы для скачивания:
Скачать видео
-
Информация по загрузке: