AWQ для квантования LLM
Автор: MIT HAN Lab
Загружено: 2023-10-25
Просмотров: 13746
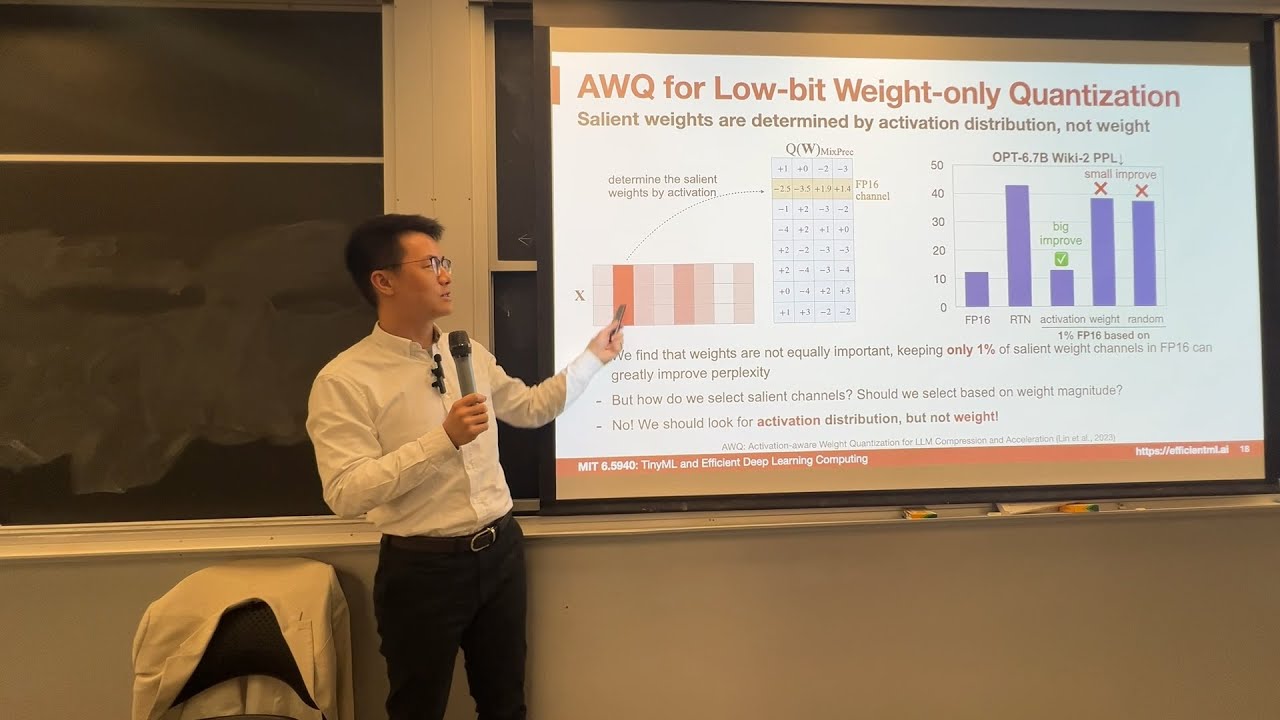
Описание: Большие языковые модели (LLM) продемонстрировали отличную производительность при решении различных задач, но астрономический размер модели повышает аппаратный барьер для обслуживания (объем памяти) и замедляет генерацию токенов (пропускную способность памяти). В данной статье мы предлагаем квантование весов с учетом активации (AWQ) – аппаратно-дружественный подход к квантованию LLM с использованием только низкобитных весов. Наш метод основан на наблюдении, что веса не одинаково важны: защита только 1% значимых весов может значительно снизить ошибку квантования. Затем мы предлагаем искать оптимальное масштабирование по каналам, которое защищает значимые веса, наблюдая за активацией, а не за весами. AWQ не использует обратное распространение или реконструкцию, поэтому он может хорошо сохранять обобщающую способность LLM в различных доменах и модальностях, не переобучаясь на калибровочном наборе. AWQ превосходит существующие работы по различным языковым моделированию и предметно-ориентированным бенчмаркам. Благодаря лучшему обобщению он обеспечивает превосходную производительность квантования для LM-моделей с настраиваемыми инструкциями и, впервые, для многомодальных LM-моделей. Наряду с AWQ мы реализуем эффективную и гибкую инфраструктуру вывода, адаптированную для LM-моделей на периферии, предлагающую более чем трёхкратное ускорение по сравнению с реализацией Huggingface FP16 как на настольных, так и на мобильных графических процессорах. Он также упрощает развертывание модели 70B Llama-2 на мобильных графических процессорах. Код: https://github.com/mit-han-lab/llm-awq
Повторяем попытку...
Доступные форматы для скачивания:
Скачать видео
-
Информация по загрузке: