Видео с ютуба Moe-Cache-Mib

llama.cpp PR #29887: GPU Cache for MoE Experts

Внутри llama.cpp: как запускать огромные MoE-модели (новый кэш экспертов)

llama.cpp's MoE Cache: 3x On 16GB. Off By Default.

The LRU Cache That Doubled Local MoE Speeds: llama.cpp Expert Offloading

This New Cache Makes Huge Local AI Models 2x Faster

Your MoE Model Is 2× Slower Without This llama.cpp Flag
mOE's QUICK TIPS: CACHE B HOLD CS:GO

llama.cpp увеличил скорость вашего GPU в 2 раза на больших моделях (включите это)

Broken in 12 Days: How a 1993 Idea Fixed llama.cpp MoE Caching

Run 125B Models on 8GB Ram: llama.cpp Expert Cache

llama.cpp Just Got an Expert Cache. Do You Still Need Strata?
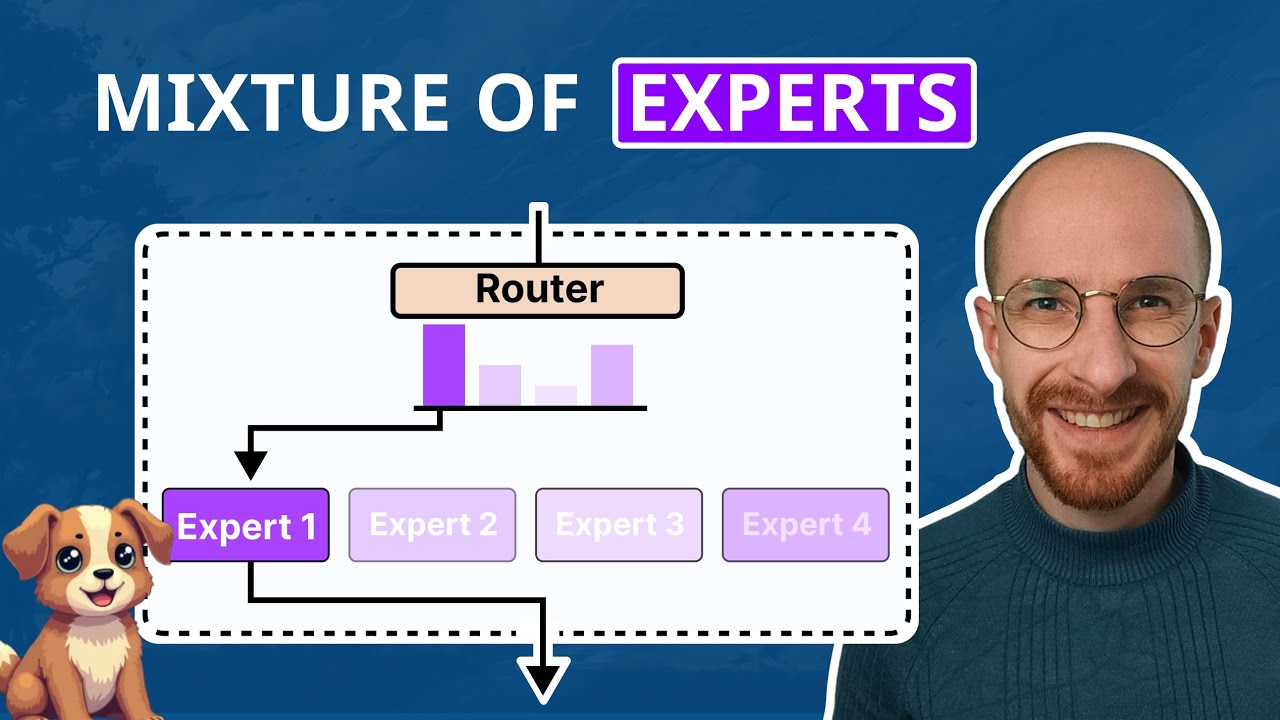
Визуальное руководство по составу экспертов в программах магистратуры по праву.

llama.cpp Just Made 125B MoE Models 4× Faster!

В llama.cpp добавили Expert Cache... Победит ли он Strata на 12 ГБ?!
Карта CACHE официально вернулась! (Новая карта)

llama.cpp Cut 31 Wasted GPU Passes
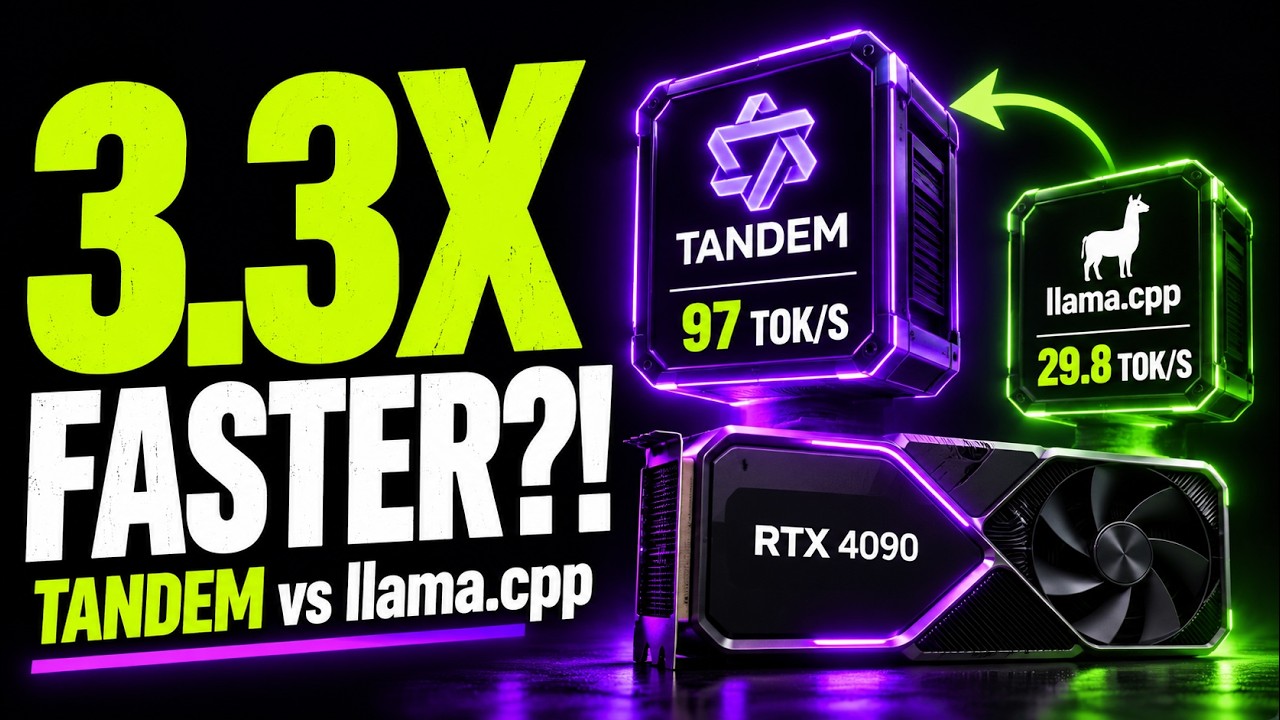
This llama.cpp Fork Just Made Qwen 3.3× Faster

The MoE Trap: Why 3B Active Doesn't Mean 3GB of VRAM (Qwen 35B)

llama.cpp runs MoE models up to 2.2x faster when VRAM runs out

How KV Cache Speeds Up LLMs for Faster AI Models on GPUs